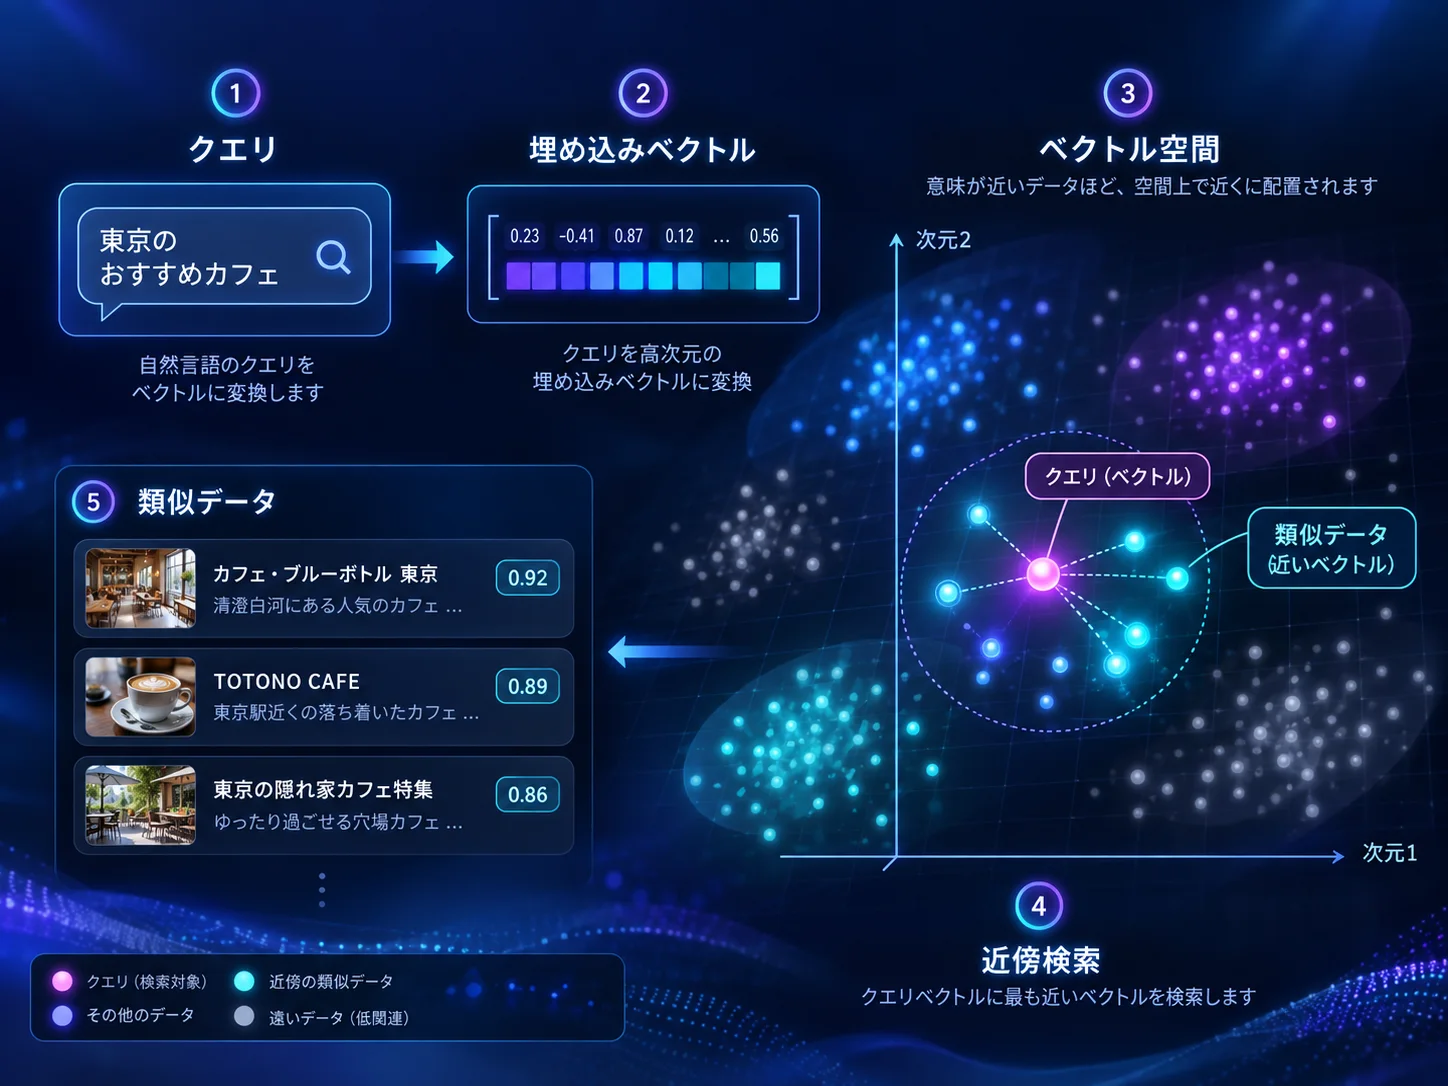
仕様書などの文章をベクトル検索できる機能の追加について
オープンソースなどの製品開発において、仕様書の作成はAIを利用した開発に限らず非常に重要なのですが、様々な製品やライブラリーを同時に作成していると、この仕様書の管理が非常に大変になってきます。そこで、せめて検索だけでも簡単にしようと重い、ベクトル検索を実装してみることにしました。
ベクトルって何よ?#
最初にベクトルと聞いても、一般の人には意味がさっぱりだと思うので、ベクトルを最初に簡単に説明していきたいと思います。ベクトルという言葉は、理系の高校生であれば、学校の授業(代数幾何、今の時代だと数学Cかな?)などで出てくるので、ほんのりと覚えている人もいると思いますが、文系の学校の方にはさっぱりだと思います。まずベクトルを簡単に理解するには地図です。
目の前に地図があり、東京駅から池袋駅に線を引いてみてください。結論を言えばこれがベクトルの基本概念です。これを数字化すると、横3センチ、縦5センチの長方形の対角線に引かれた矢印線です。要するにベクトルとは、ある点からある地点への『向きと長さ』を表すものです。地図の場合は縦と横の2次元ですが、これに高さが加わると3次元となり、物理の世界では物の移動量だったり色々活躍できる考え方になります。
どらえもんの4次元ポケットは、縦・横・高・時間の4つの軸だと思われますw(アインシュタイン的には第4の軸は時間ですが、どらえもんの場合は3次元空間に断裂し存在する4次元空間かも)。さて先ほどの横3センチ、縦5センチという値を、こんどは複数持つ事で論理上は他次元のベクトルを表現することが可能です。3次元は自分達の世界のことなので分かり易いのですが、これを1024次元とか1536次元とか4096次元とか、粒度の基準として次元数を決める事でより精密なベクトルになってきます。この多次元の場合は、只の表現方法としてとらえるほうが良いです。現実の3次元とは想像が付かなくて返って誤解の元になってしまう可能性があります。注目するべきは「向きと量」を表現するものと覚えれば良いと思います。
実は最近のAI(LLM)でも使っている。#
最近のAI技術において、大きなステップになったのがこの文章のベクトル化などです。単語ではなく一定の文章をベクトルという形に計算しやすい形に変え、次の文章を作成するように計算を行うのが、いわゆるLarge Language Model:通称LLM と言われるもので、今回のベクトル検索でも同じように単語ではなく文章の意味として1つのベクトルデータとして管理することで、検索の精度を上げ、LLMであれば正確に意味をつかみとる部分となります。
ただこれは、文章のAIの話であって、画像作成のAIなどは拡散モデル(Diffusion Model)など全く違う理論で作成されているので、興味がある方は別途調べてみてください。
現状の仕様書と実装について#
現在、黒兎の開発環境は Cloudflare 社のシステム上にて構築していることから、D1 という SQLite ベースのデータベースを利用して、仕様書の管理を行っています。最初の頃は、リポジトリの中に md や html などのファイル形式でファイルとしておいて置いたのですが、様々な製品やライブラリーを開発しようとすると、仕様書は色々な所に存在することになり、古かったり新しかったり、2つあったりと管理がとても大変でした。
そこで現在は、先日の記事の通りにリポジトリー自体は、1つにしたモノリポジトリーでの管理方式にして、仕様書は開発基盤システムを作成し、API 及び ブラウザからの仕様書修正や作成をすることで、ばらばらに散らばりがちな仕様書や課題の状況などを一括管理して、様々な絞り込みや抽出ができるようになり、どこかで作成した仕様書もすぐに見つかるようになりました。
しかし、AI を多用する現在の開発方法では、1つ1つの仕様書を検索させては、トークン(利用量みたいなもの)の無駄遣いになってしまいます。そこで全文検索を導入するにあたり、ベクトル検索機能を導入することで、更に利便性の向上をさせようというのが今回の設計の趣旨になります。
基本的な仕組み#
先に伝えたように、現状は仕様書などの文章データは D1 データベースに保管されています。これに新しく、Cloudflare Vectorize という、ベクトルデータベース専用サービスを利用します。仕様書のD1から文章を抽出し、Cloudflare Worker AI を使い、この Cloudflare Vectorize(以下、CF Vectorizeと呼びます) に文章をベクトル情報として保存します。
Cloudflare Worker AIの無料枠
- Workers AI全体で、1アカウントあたり毎日10,000 Neuronsまで無料
- 超過分だけ課金
- 無料枠は毎日UTC 00:00、日本時間09:00にリセット
- 無料枠はBGE-M3専用ではなく、同じアカウントのWorkers AIモデル全体で共有
今回は、埋め込みモデル @cf/baai/bge-m3 を使用しています。このモデルは文章の意味を数値の並びに変換する埋め込みモデルとして使用しており、このBGE-M3自体は多言語対応の埋め込みモデルなので、日本語の仕様書と日本語の検索文を同じ数値空間に配置できます。
Cloudflare Vectorize の無料枠
- 保存:500万ベクトル次元
- 検索:月3,000万ベクトル次元
- 超過課金:なし。上限を超えて継続利用するにはPaidへの移行が必要
- エグレス、CPU、インデックス維持時間:追加料金なし
黒兎のアカウントは、Paidアカウントなので、保存1,000万次元枠には収まっていますが、通常の無料枠でははみ出てしまう量でした。基本は簡単で、Worker AI を使って、D1 の仕様書の単語を、cron(定期的な処理) などのサービスに登録して、更新があったら文章をベクトル化して Vectorize データベースに登録するという形です。検索時は検索文章を、Worker AI でベクトル化して、算出されたベクトル値を元に Vectorize で検索して、対象となった仕様書を D1 から読み出して提示するという流れになります。
利用した感じは?#
今回のベクトル検索を導入してみた感想は、超便利w。通常では単語での検索で、例えば「端末」とか「紛失」とかの検索キーワードになりますが、これが「端末紛失時のアカウントについて」とかで、関係しような仕様書のリスト表示してくれるようになりました。ただ無料枠の範囲が小さくて、文章の量が多いとCloudflare Vectorizeの無料範囲での利用は難しそうです。
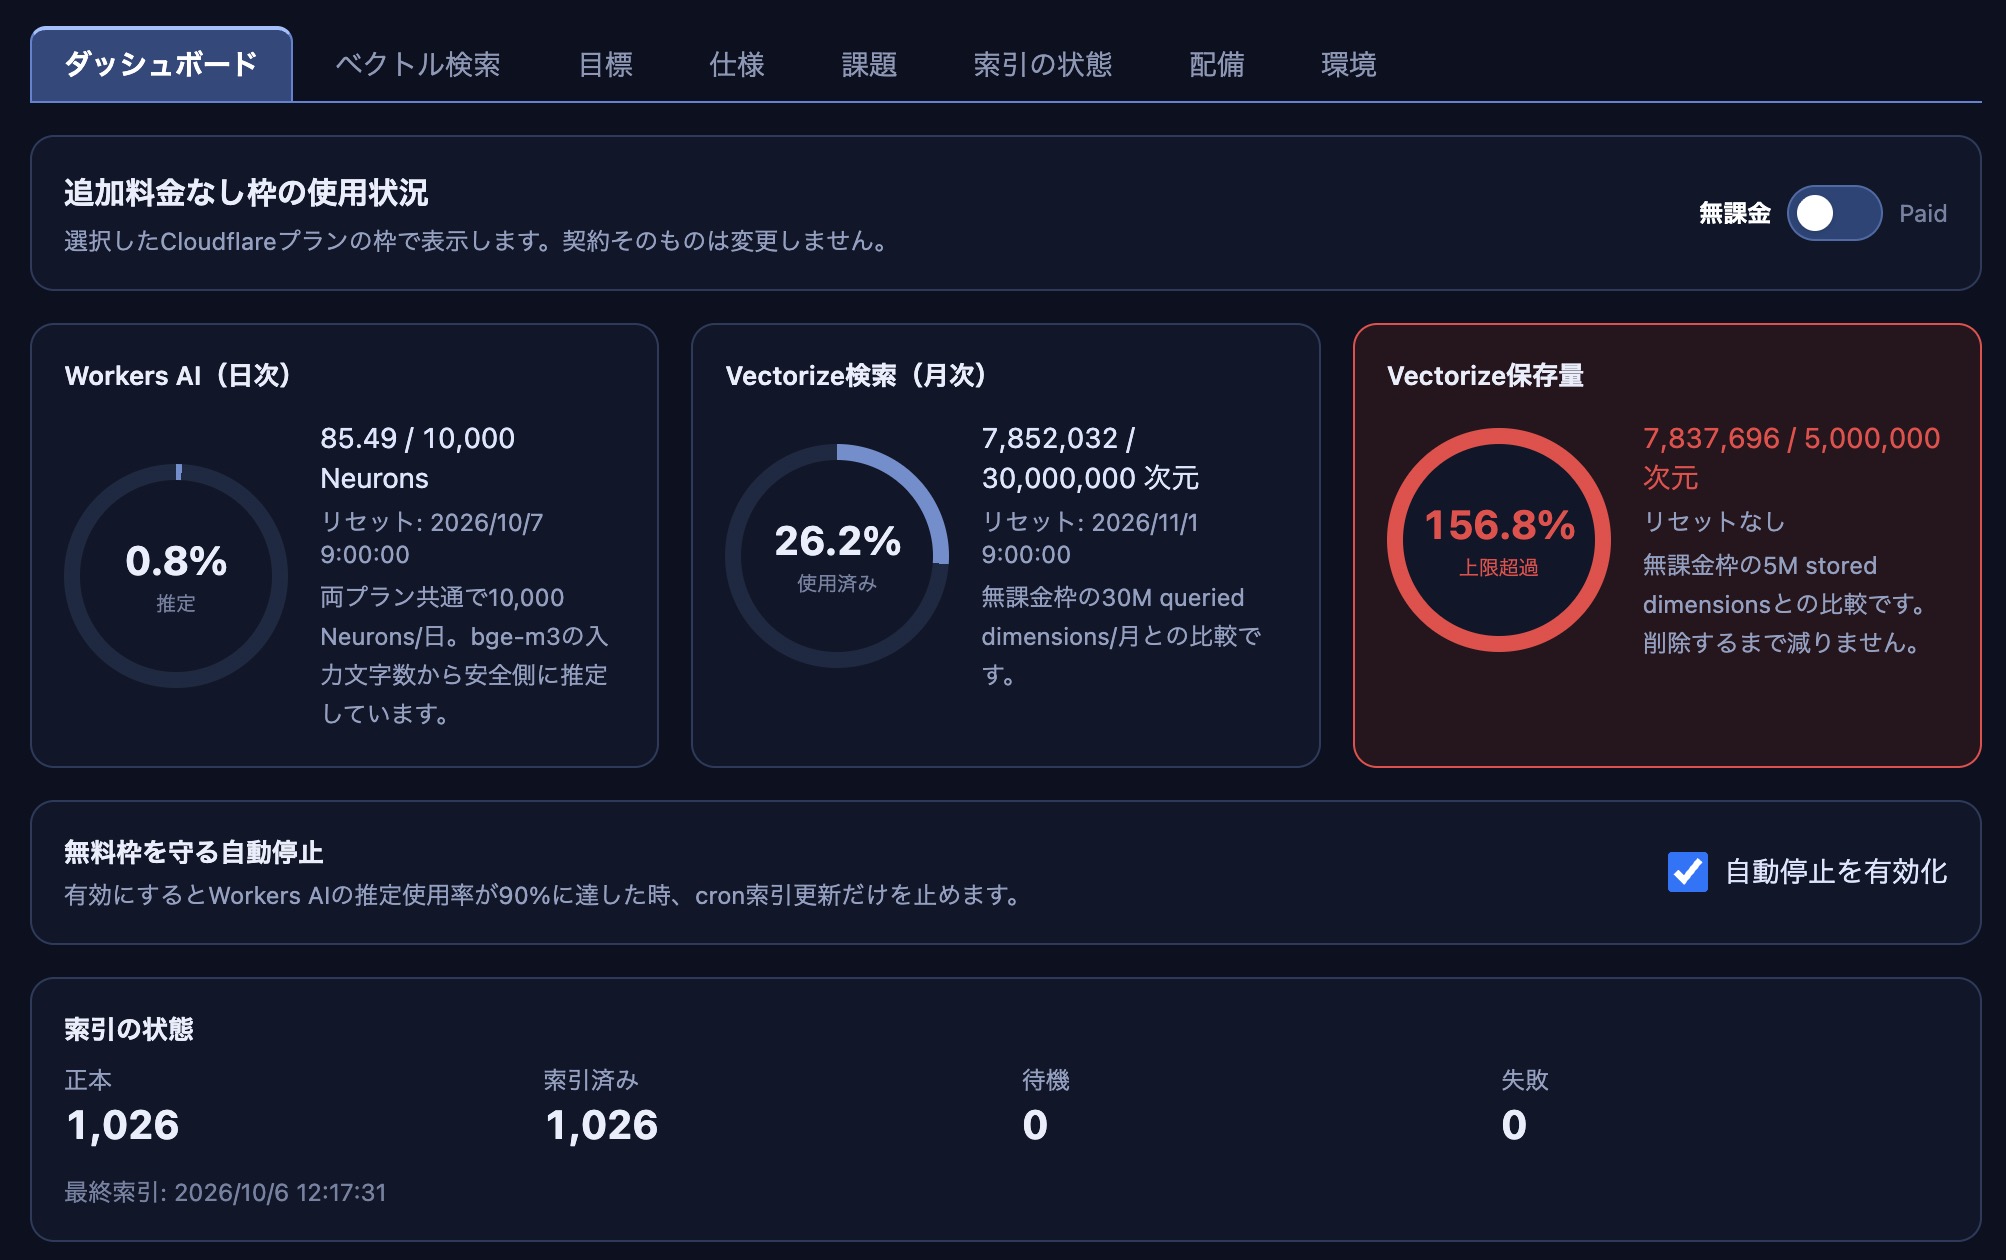
この画面は今回作成した ベクトル検索の管理画面ですが、無料枠ではすでにオーバーしていることがわかります。Worker AI は毎日初期化されるので、検索を後日に平準化させることで解決できますが、ベクトルデータは削減できないので、どうしてもオーバーしてしまいます。
正直、すでにPaidプランの方には使えそうな印象ですが、無料枠だけでの構築は難しい判断になりそうです。これからベクトルデータベースを Cloudflare で使おうと思っている方の参考になれば幸いです。