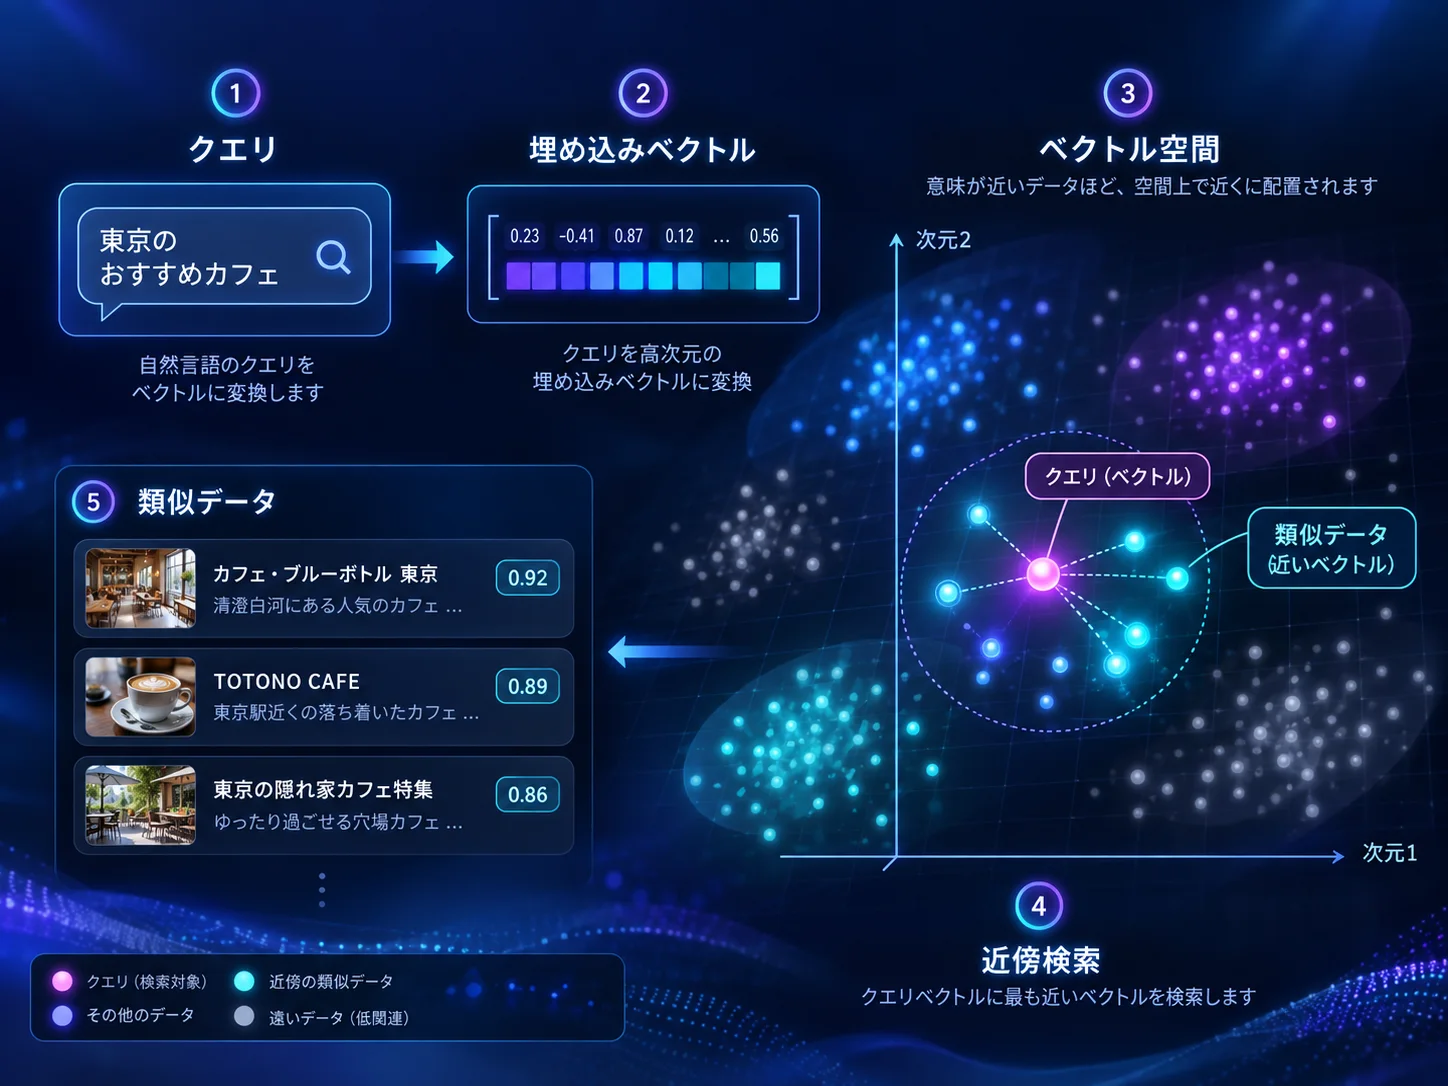
向量究竟是什么?#
初次听到“向量”这个词时,普通人可能完全不解其意。如果是理科高中的朋友,可能在数学课(代数几何等)上接触过而略有印象,但文科背景的朋友可能会感到十分陌生。理解向量最简单直观的方法就是看地图。
请想象眼前有一张地图,在东京站与池袋站之间画一条连线。简而言之,这就是向量的基本概念。如果将其数字化,就是在一个横向3厘米、纵向5厘米的长方形对角线上画出的带箭头的线段。换言之,向量就是表示从某一点到另一点的“方向与大小(长度)”。在地图上是二维(纵横)的,若再加上高度就变成了三维,在物理学中常用于描述物体的位移量等各种场景。
哆啦A梦的四次元口袋大概就是长、宽、高和时间四个维度(爱因斯坦理论中第四维是时间,但在哆啦A梦中也许是独立存在于三维空间裂缝中的四维空间)。如果把刚才横3厘米、竖5厘米的数值扩展为多个数值,理论上就能表达更高维度的向量。三维就是我们生活的现实世界所以容易理解,而将维度设定为1024维、1536维或4096维等作为粒度标准时,向量就能表达更精细的信息。对于高维多维情况,最好将其视为一种数学表达方式。如果硬去想象现实的三维形态反而容易产生误解。只要记住它是用来表示“方向与量”的即可。
如今的大语言模型(LLM)也在广泛使用#
在近年来的AI技术中,文本向量化是一个巨大的突破。将文本转换为易于计算的向量,从而计算并生成下一个词句,这就是大型语言模型(LLM)的核心机制。本次的向量检索也是如此,将整句文本的语义作为一个向量数据进行管理,从而提高检索精度,让AI能够精准把握文本的真实含义。
不过这属于文本AI的范畴,图像生成AI则采用完全不同的扩散模型(Diffusion Model)等理论,感兴趣的朋友可以另行了解。
现有的规范文档与架构实现#
目前黑兔的开发环境构建在 Cloudflare 平台之上,使用基于 SQLite 的 D1 数据库来统一管理规范文档。早期曾将规范以 Markdown 或 HTML 文件形式直接存放在代码仓库中,但随着多款产品和类库的并行开发,规范文档散落在各处,版本新旧不一、重复冗余,管理起来极为困难。
因此正如前文所述,我们采用了单一代码仓库(Monorepo)的管理方式,并搭建了开发基础设施系统。通过 API 和浏览器直接对规范文档进行编辑与创建,集中管理分散的规范与任务状态,支持各种筛选与提取,使任何地方编写的规范都能立即被查找到。
然而,在深度应用 AI 的开发流程中,如果让 AI 逐篇遍历搜索规范文档,会造成大量 Token 的浪费。因此在引入全文检索的同时,我们引入了向量检索功能,以进一步提升便捷性——这就是本次设计的核心目标。
基本运作机制#
如前所述,规范文档等文本数据保存在 D1 数据库中。在此基础上,我们引入了专用的向量数据库服务 Cloudflare Vectorize。从 D1 中提取文本,通过 Cloudflare Workers AI 进行向量化处理,并将文本以向量信息的形式存入 Cloudflare Vectorize(以下简称 CF Vectorize)。
Cloudflare Workers AI 免费额度
- 整个 Workers AI 每个账户每天免费提供 10,000 Neurons
- 超出部分按量计费
- 免费额度于每天 UTC 00:00(北京时间 08:00 / 日本时间 09:00)重置
- 并非 BGE-M3 独占,而是同账户下所有 Workers AI 模型共享
本次使用的嵌入模型是 @cf/baai/bge-m3。该模型用于将文本语义转换为数字序列。由于 BGE-M3 原生支持多语言,因此日语规范文档与日语搜索词句能够被映射到同一个数值向量空间中。
Cloudflare Vectorize 免费额度
- 存储:500万向量维度
- 查询:每月3,000万向量维度
- 超额扣费:无超额扣费(达到上限后需升级至付费方案方可继续使用)
- 出站流量、CPU及索引维护时间:无额外费用
由于黑兔的账户是付费账户,因此能够轻松容纳在1000万维度的存储额度内,但对于常规免费额度来说则会超出。整体流程非常简明:利用 Workers AI 通过 Cron 定时任务检测 D1 规范的更新,更新时将文本转化为向量并写入 Vectorize 数据库。检索时,通过 Workers AI 将搜索语句向量化,基于计算出的向量值在 Vectorize 中进行相似度检索,最后从 D1 中读取匹配的规范文档并呈现给用户。
实际使用体验#
引入向量检索后的实际体验是:极其方便! 过去关键词检索只能搜“终端”或“丢失”这类词,而现在输入“终端丢失时的账号处理流程”也能精准列出相关规范文档。不过由于免费额度相对较小,文档量较大时仅凭 Cloudflare Vectorize 的免费额度可能难以支撑。
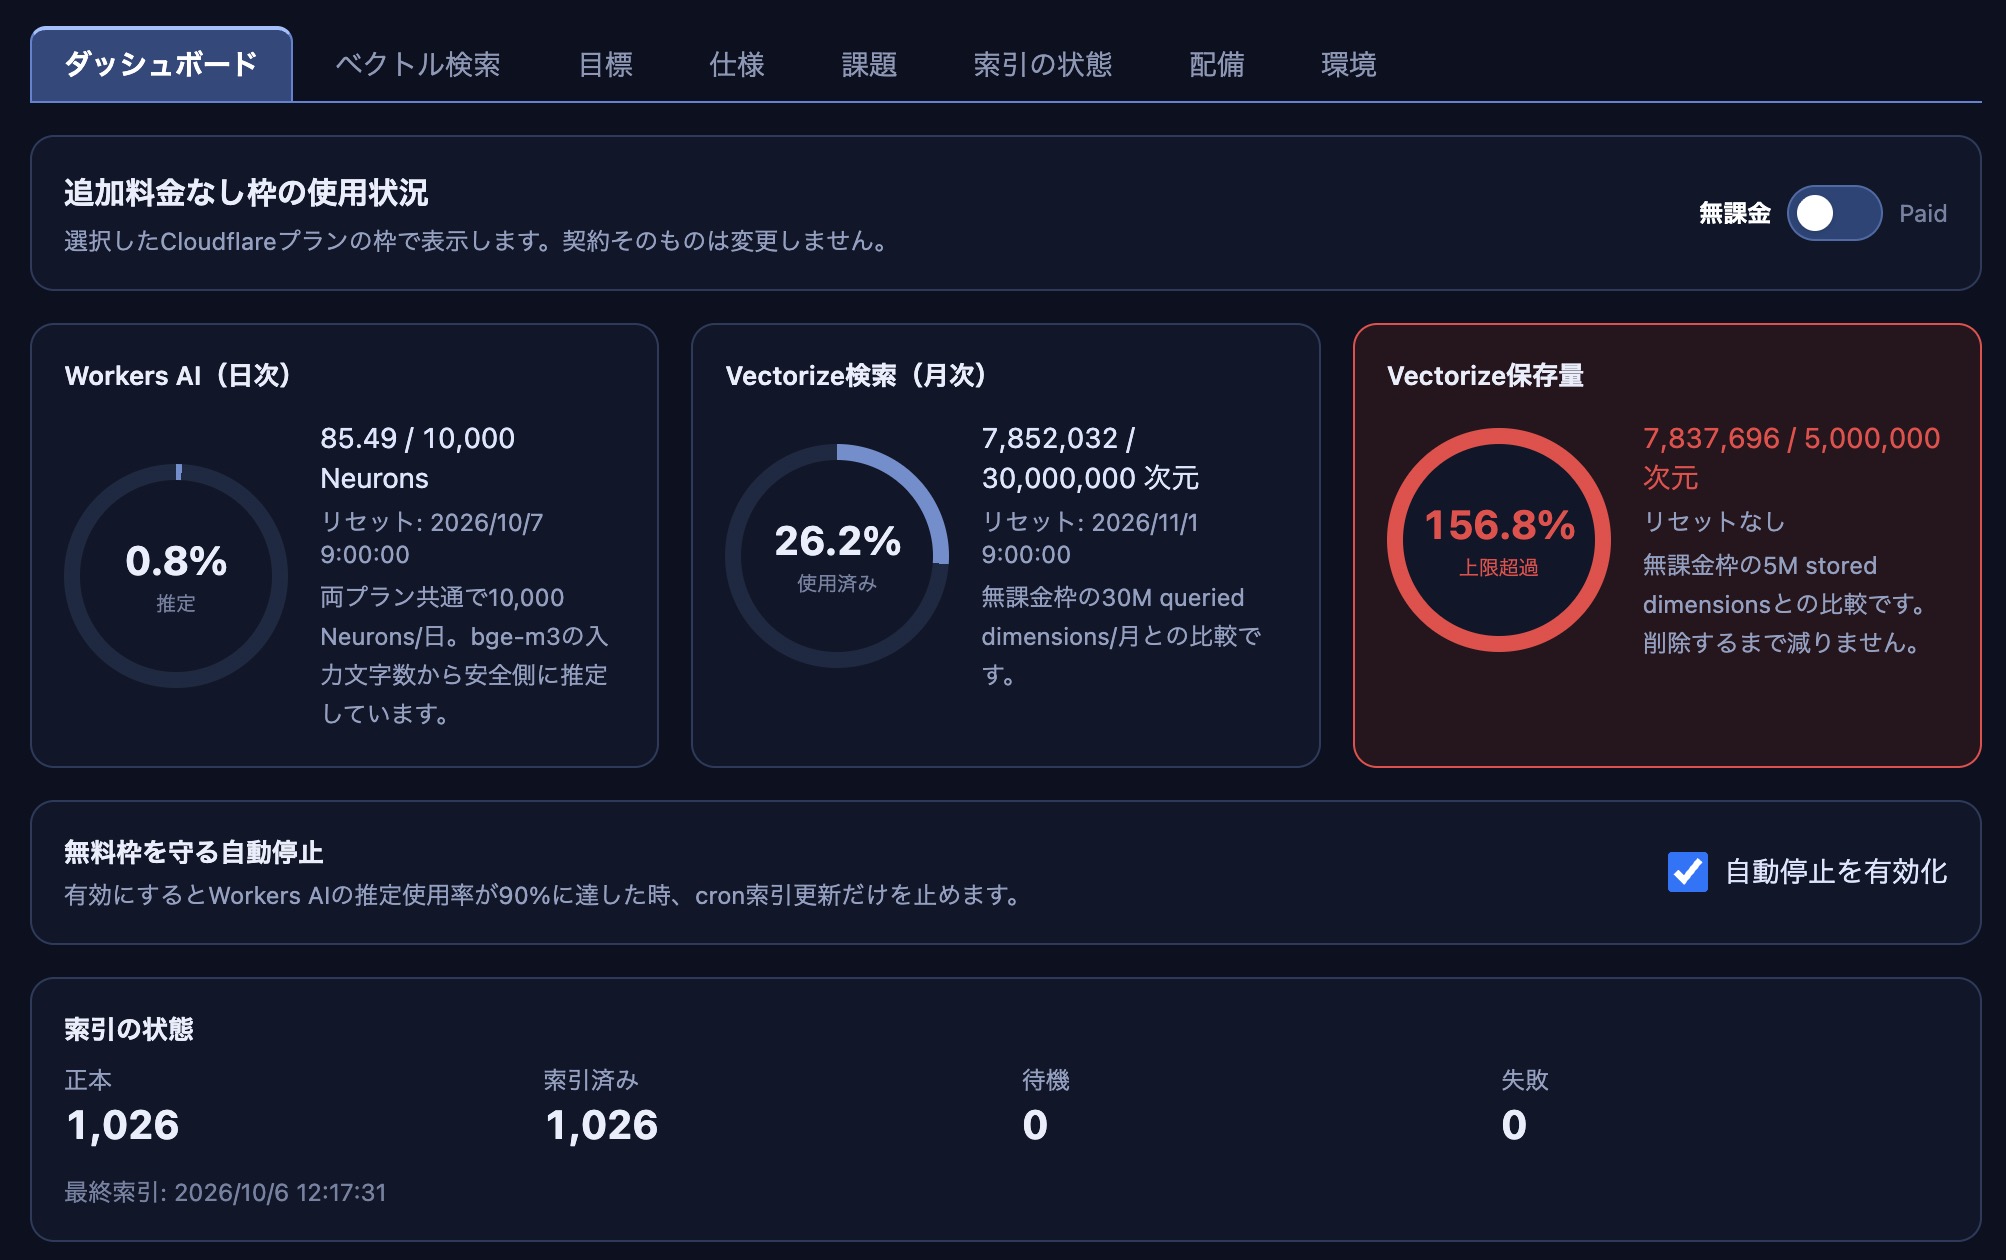
上方展示的是我们本次开发的向量检索管理后台界面,可以看到已经超出了免费额度。虽然 Workers AI 每天重置(可以通过后续日期分摊检索负载),但向量存储数据是持续累积且无法随意缩减的,因此必然会超出免费限制。
坦白说,对于已有付费计划的团队来说非常实用,但若仅想依赖免费额度则需要谨慎权衡。希望本文能为计划在 Cloudflare 上使用向量数据库的朋友提供参考。