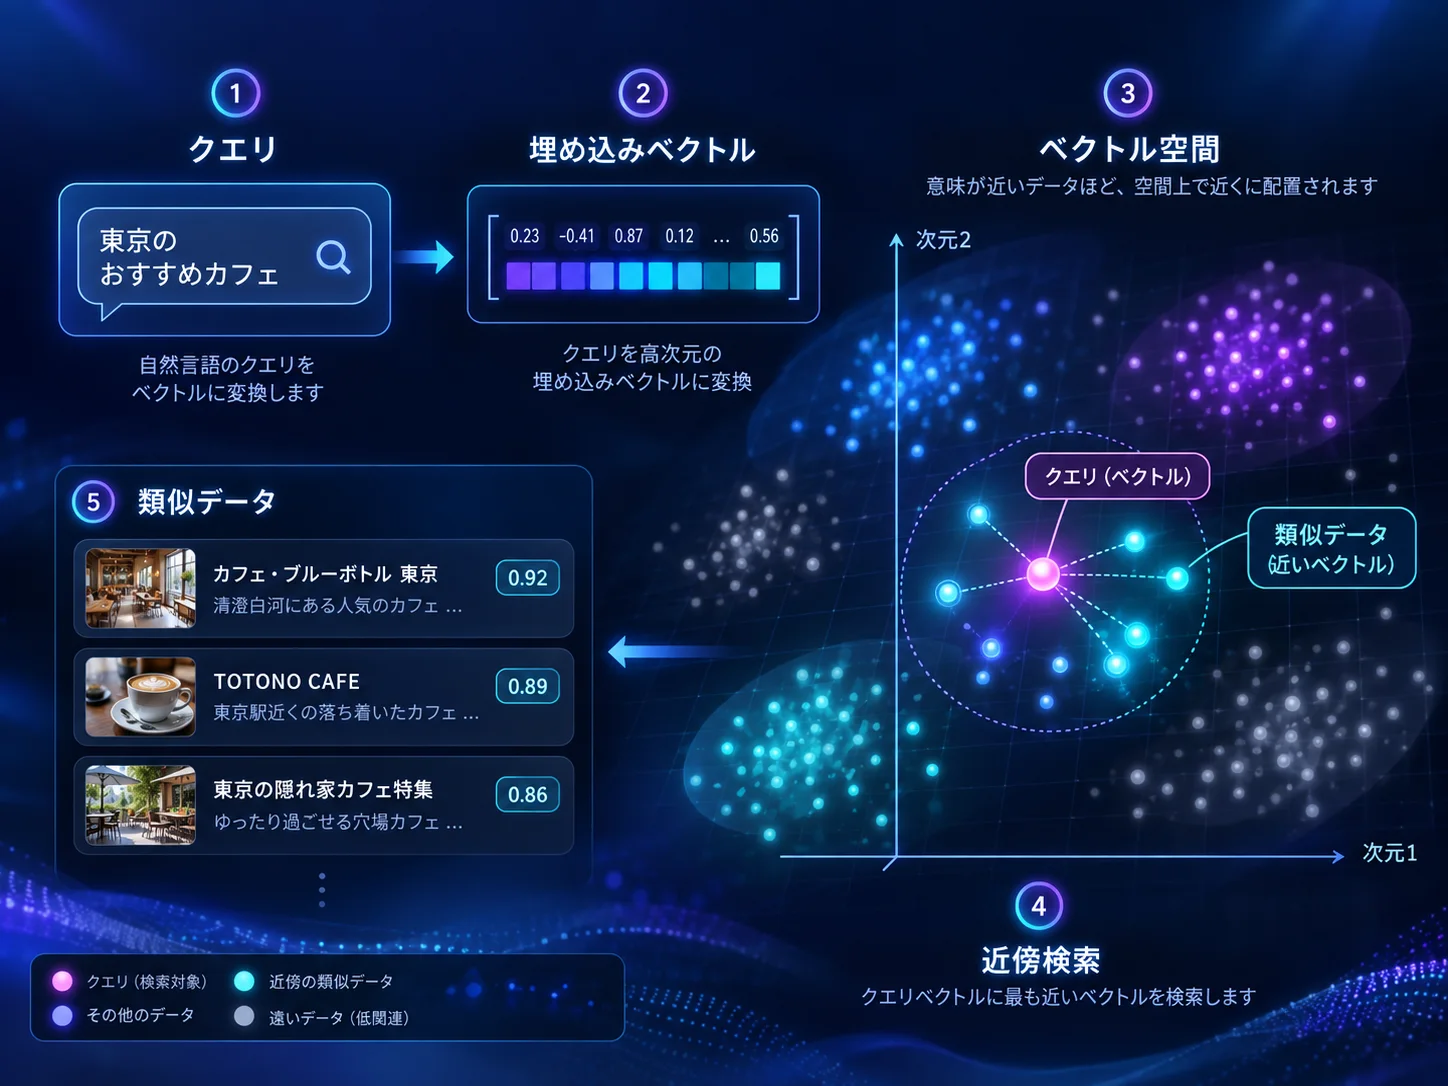
벡터란 대체 무엇인가요?#
처음 '벡터'라는 단어를 들으면 일반인에게는 생소하게 느껴질 수 있습니다. 이과 출신 고등학생이라면 수학 수업(기하와 벡터 등)에서 접해 어렴풋이 기억할 수도 있지만, 문과 출신에게는 낯설기 마련입니다. 벡터를 가장 쉽게 이해하는 방법은 바로 지도입니다.
눈앞에 지도가 있다고 생각하고, 도쿄역에서 이케부쿠로역까지 선을 그어보세요. 결론부터 말하면 이것이 바로 벡터의 기본 개념입니다. 이를 수치화하면 가로 3cm, 세로 5cm 직사각형의 대각선에 그려진 화살표 선입니다. 요컨대 벡터란 어떤 지점에서 다른 지점으로 향하는 '방향과 크기(길이)'를 나타내는 것입니다. 지도는 가로와 세로의 2차원이지만, 여기에 높이가 더해지면 3차원이 되며 물리학에서 물체의 이동량을 표현할 때 다양하게 활용됩니다.
도라에몽의 4차원 주머니는 가로·세로·높이·시간의 4개 축으로 볼 수 있습니다(아인슈타인에 따르면 4번째 축은 시간이지만, 도라에몽은 3차원 공간에 단절되어 존재하는 별도 4차원 공간일 수도 있습니다). 앞서 언급한 가로 3cm, 세로 5cm 같은 값을 여러 개 갖게 되면 논리적으로 다차원 벡터를 표현할 수 있습니다. 3차원은 우리가 사는 세계라 이해하기 쉽지만, 이를 1024차원, 1536차원, 4096차원 등 세분화 기준에 따라 차원 수를 정하면 훨씬 정밀한 벡터가 됩니다. 이러한 고차원 벡터는 수학적 표현 방식으로 받아들이는 것이 좋습니다. 주목해야 할 핵심은 '방향과 양'을 표현한다는 점입니다.
최신 AI(LLM)에서도 핵심적으로 활용되는 기술#
최근 AI 기술의 큰 도약 중 하나가 바로 이 문장의 벡터화입니다. 단어가 아닌 일정한 문장을 계산하기 쉬운 벡터 형태로 변환하여 다음 문장을 예측·생성하는 것이 대형 언어 모델(LLM)의 핵심입니다. 이번 벡터 검색 역시 단어가 아닌 문장의 의미를 하나의 벡터 데이터로 관리함으로써 검색 정확도를 대폭 높이고 문맥을 정확히 파악할 수 있도록 구현했습니다.
다만 이는 텍스트 AI에 관한 이야기이며, 이미지 생성 AI 등은 확산 모델(Diffusion Model) 등 전혀 다른 원리로 작동합니다.
기존 명세서 현황과 아키텍처 구현#
현재 쿠로우사기(Kurousagi)의 개발 환경은 Cloudflare 시스템 기반으로 구축되어 있어, SQLite 기반의 D1 데이터베이스를 이용해 명세서를 관리하고 있습니다. 초기에는 저장소 내에 마크다운(.md)이나 HTML 파일 형태로 두었으나, 여러 제품과 라이브러리를 동시 개발하면서 명세서가 분산되고 중복되거나 버전 관리가 매우 까다로워졌습니다.
이에 따라 저장소를 모노레포(Monorepo) 방식으로 일원화하고 개발 인프라 시스템을 구축했습니다. API 및 브라우저에서 직접 명세서를 작성·수정할 수 있도록 하여 분산된 문서와 이슈를 통합 관리하고, 다양한 필터링 및 조회가 가능해져 필요한 문서를 즉시 찾을 수 있게 되었습니다.
하지만 AI를 적극 활용하는 최근 개발 방식에서 명세서를 하나하나 전부 검색하게 하면 토큰(사용량) 낭비가 심해집니다. 따라서 전문 검색을 도입함과 동시에 벡터 검색 기능을 추가하여 개발 효율성을 대폭 높였습니다.
기본 작동 원리#
앞서 설명했듯이 명세서 데이터는 D1 데이터베이스에 저장되어 있습니다. 여기에 전용 벡터 데이터베이스 서비스인 Cloudflare Vectorize를 새롭게 도입했습니다. D1에서 텍스트를 추출하고 Cloudflare Workers AI를 사용해 Cloudflare Vectorize(이하 CF Vectorize)에 벡터 데이터로 저장합니다.
Cloudflare Workers AI 무료 한도
- Workers AI 전체에서 계정당 매일 10,000 Neurons 무료 제공
- 초과분에 대해서만 종량제 과금
- 무료 한도는 매일 UTC 00:00(한국/일본 시간 09:00)에 리셋
- BGE-M3 전용이 아니며 계정 내 모든 Workers AI 모델이 공유
임베딩 모델로는 @cf/baai/bge-m3를 사용하고 있습니다. 이 모델은 문장의 의미를 숫자 배열로 변환하는 다국어 지원 모델이므로, 일본어 명세서와 검색어를 동일한 수치 벡터 공간에 배치할 수 있습니다.
Cloudflare Vectorize 무료 한도
- 저장 용량: 500만 벡터 차원
- 검색: 월 3,000만 벡터 차원
- 초과 과금: 없음(한도 초과 시 계속 사용하려면 Paid 플랜 전환 필요)
- Egress, CPU, 인덱스 유지 시간: 추가 비용 없음
저희 계정은 유료(Paid) 플랜이므로 1,000만 차원 한도 내에 무난히 수용되지만, 일반 무료 한도로는 초과하는 용량이었습니다. 원리는 간단합니다. Cron 정기 작업을 통해 D1의 수정된 명세서를 Workers AI로 벡터화하여 Vectorize 데이터베이스에 등록합니다. 검색 시에는 검색 문장을 Workers AI로 벡터화하고, 산출된 벡터값을 기반으로 Vectorize에서 유사도를 검색한 뒤 일치하는 명세서를 D1에서 가져와 보여주는 구조입니다.
실제 사용 후기#
벡터 검색을 직접 도입해 본 소감은 '정말 편리하다'는 점입니다! 기존에는 '단말기', '분실' 같은 키워드로만 검색해야 했지만, 이제는 '단말기 분실 시 계정 처리 절차'와 같이 자연스러운 문장으로 검색해도 연관된 명세서 목록을 정확히 찾아줍니다. 다만 무료 한도가 다소 타이트하므로, 문서 양이 많다면 유료 플랜 활용을 권장합니다.
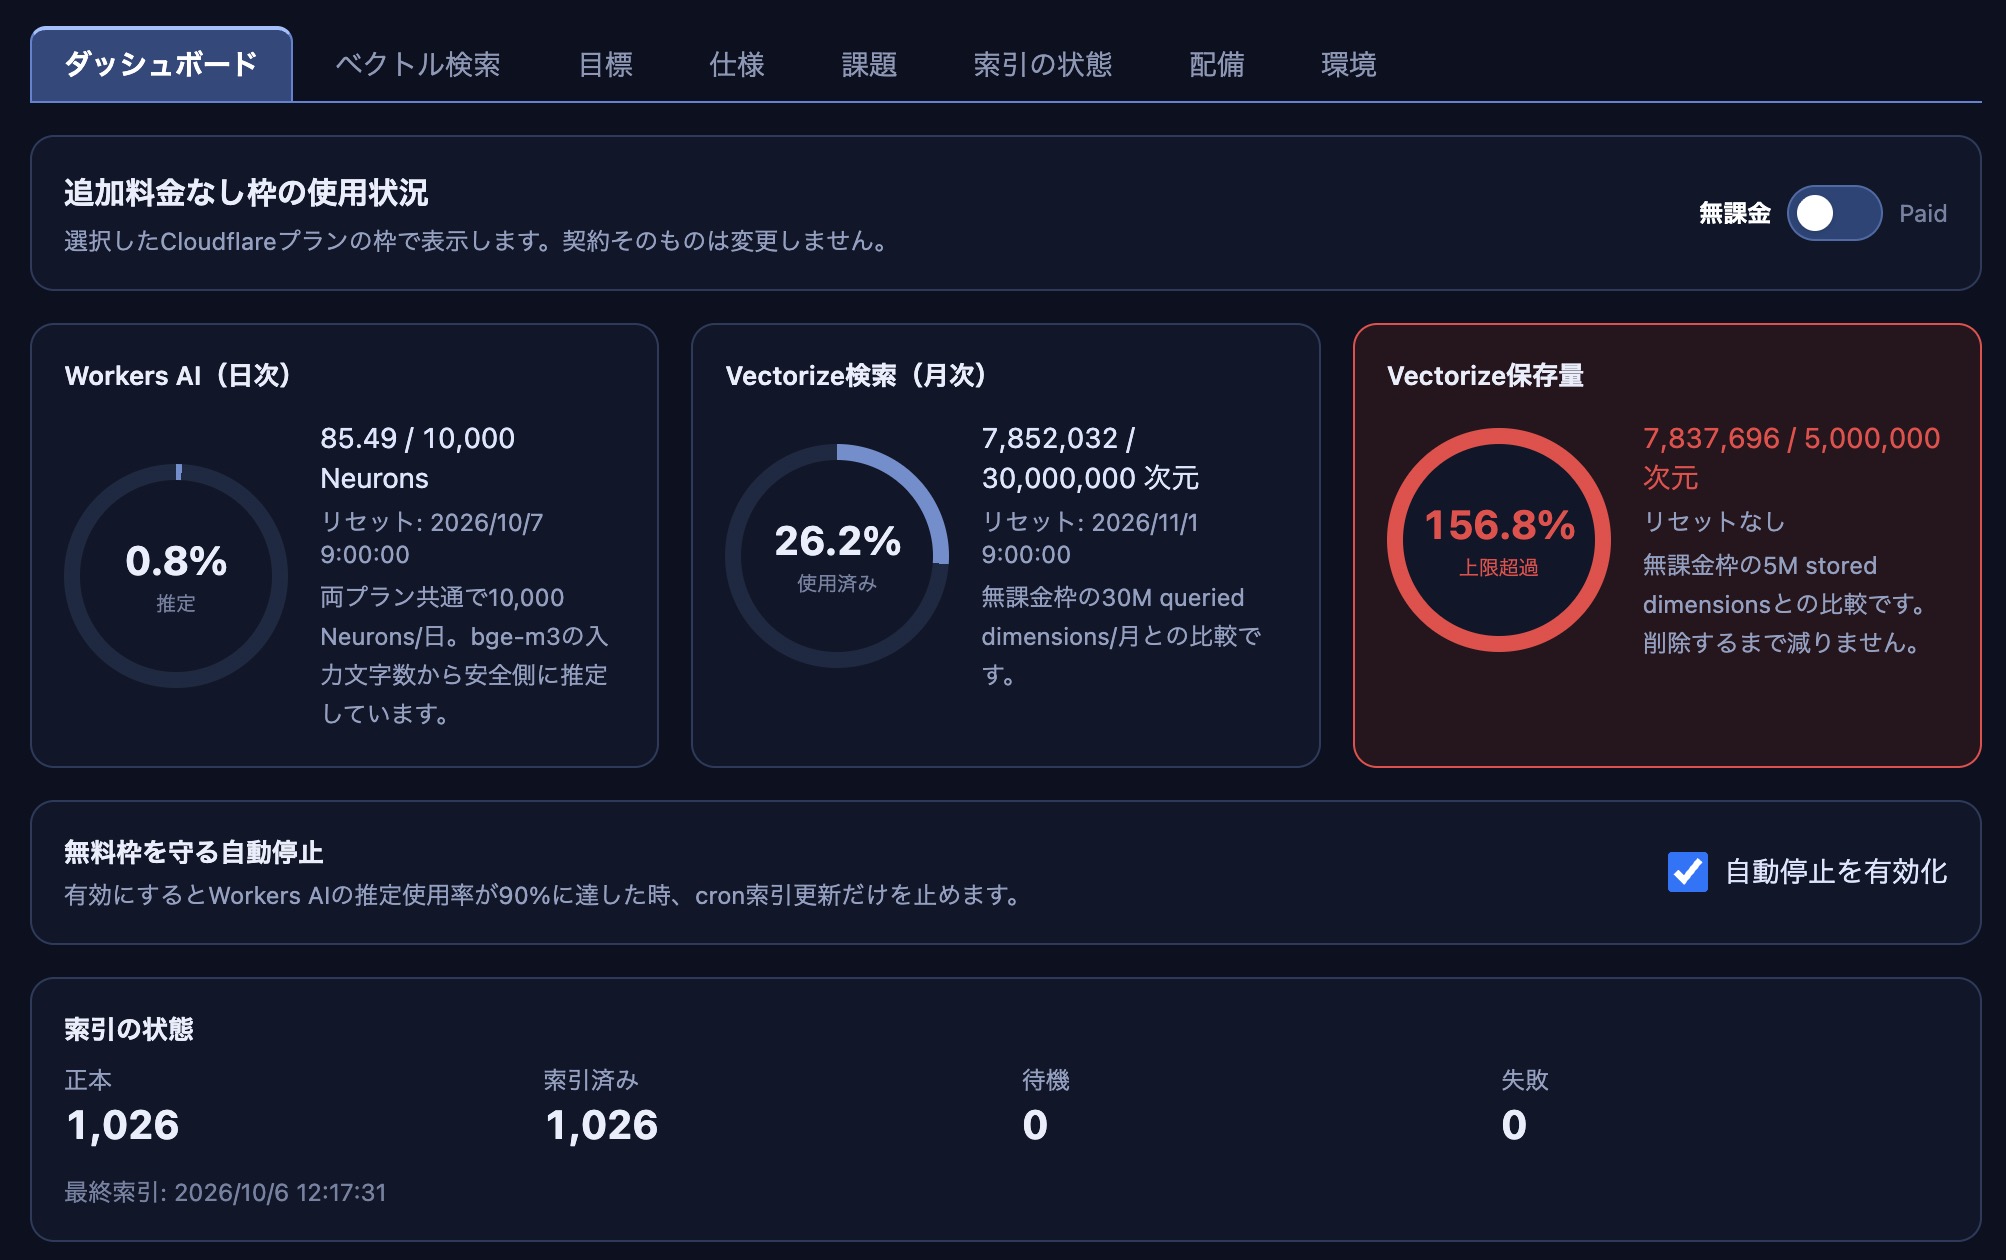
위 화면은 직접 구축한 벡터 검색 관리 화면으로, 무료 한도를 이미 초과했음을 보여줍니다. Workers AI는 매일 리셋되므로 검색량을 분산할 수 있지만, 벡터 저장 데이터는 누적되므로 용량 초과가 발생하기 쉽습니다.
이미 Paid 플랜을 사용 중인 개발자에게는 매우 유용한 도구입니다. Cloudflare에서 벡터 데이터베이스 구축을 고려 중인 분들께 도움이 되기를 바랍니다.